Gemini 4 Argonまとめ: AIの勢力図を揺るがす怪物が登場
AstraにもFableにも勝ったのに、私たちは使えない
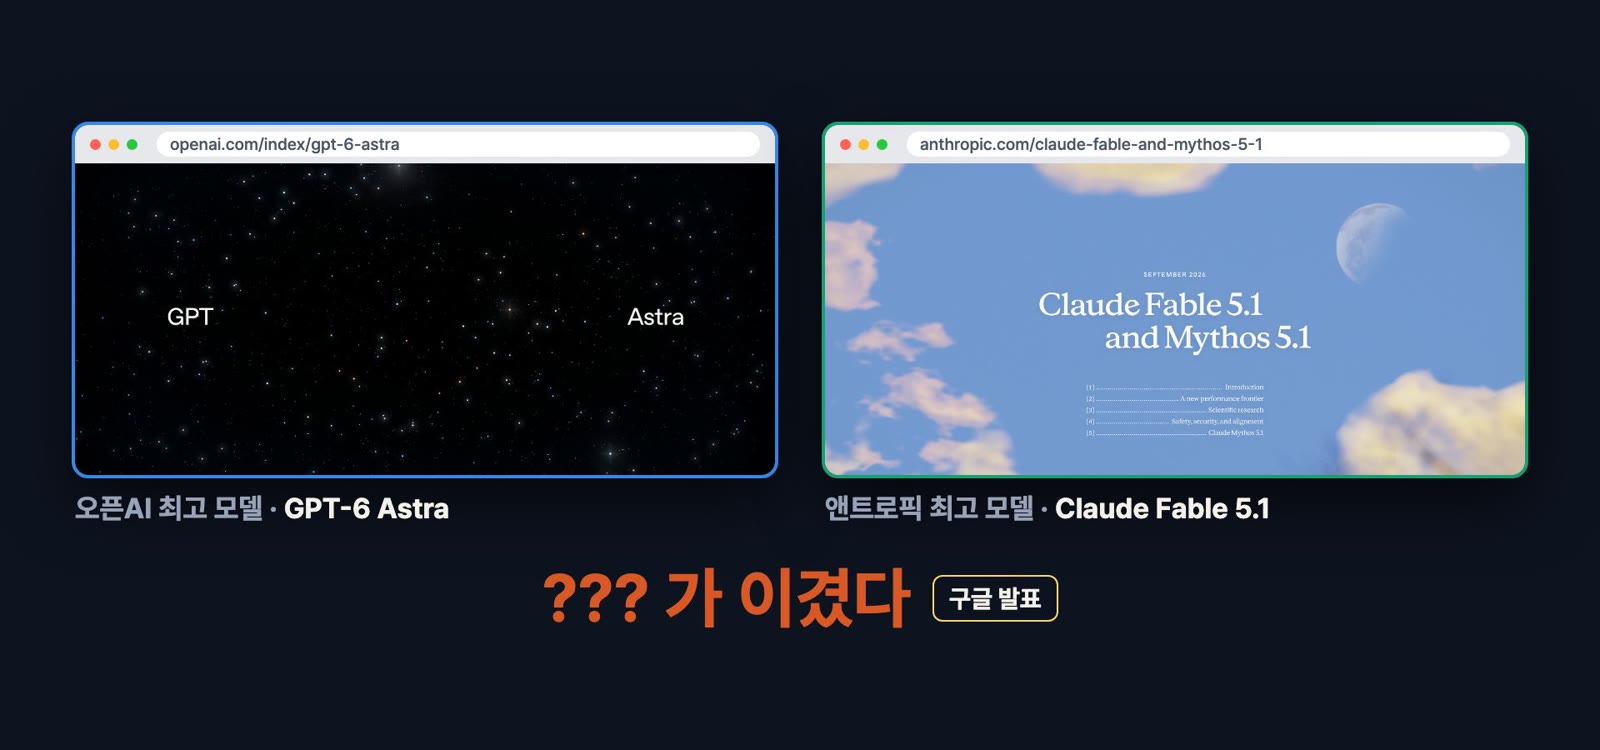
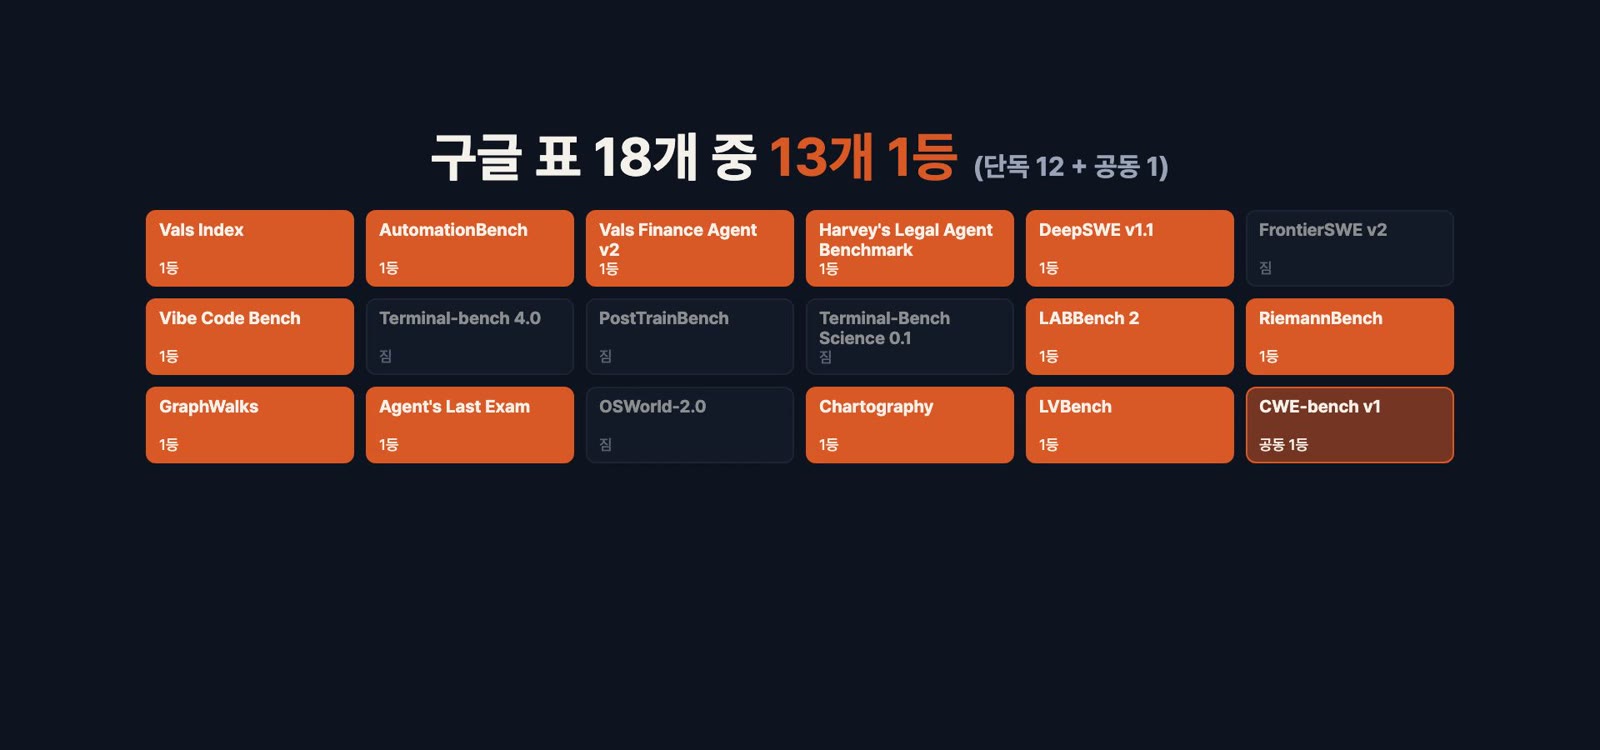
2026年9月30日(米国時間)、GoogleがGemini 4 Argonを発表しました。Googleの発表では、OpenAIの最上位モデルGPT-6 Astraにも、Anthropicの最上位モデルClaude Fable 5.1にも勝っています。Googleが公開した18のベンチマークのうち13で1位、価格はローンチ割引でAstraの5分の1です。
ところが私たちはまだアプリやAPIでは使えません。Googleが正式に最初に提供したのは、ハッキングを防ぐセキュリティチーム。しかもハッキング関連の安全装置を外した状態でです。これほど強いモデルを、なぜ私たちより先にそちらに渡したのでしょうか? これが今回のテーマです。
動画は韓国語です。以下の画像は動画のフレームです。
Googleの表だけではありません: LMArena
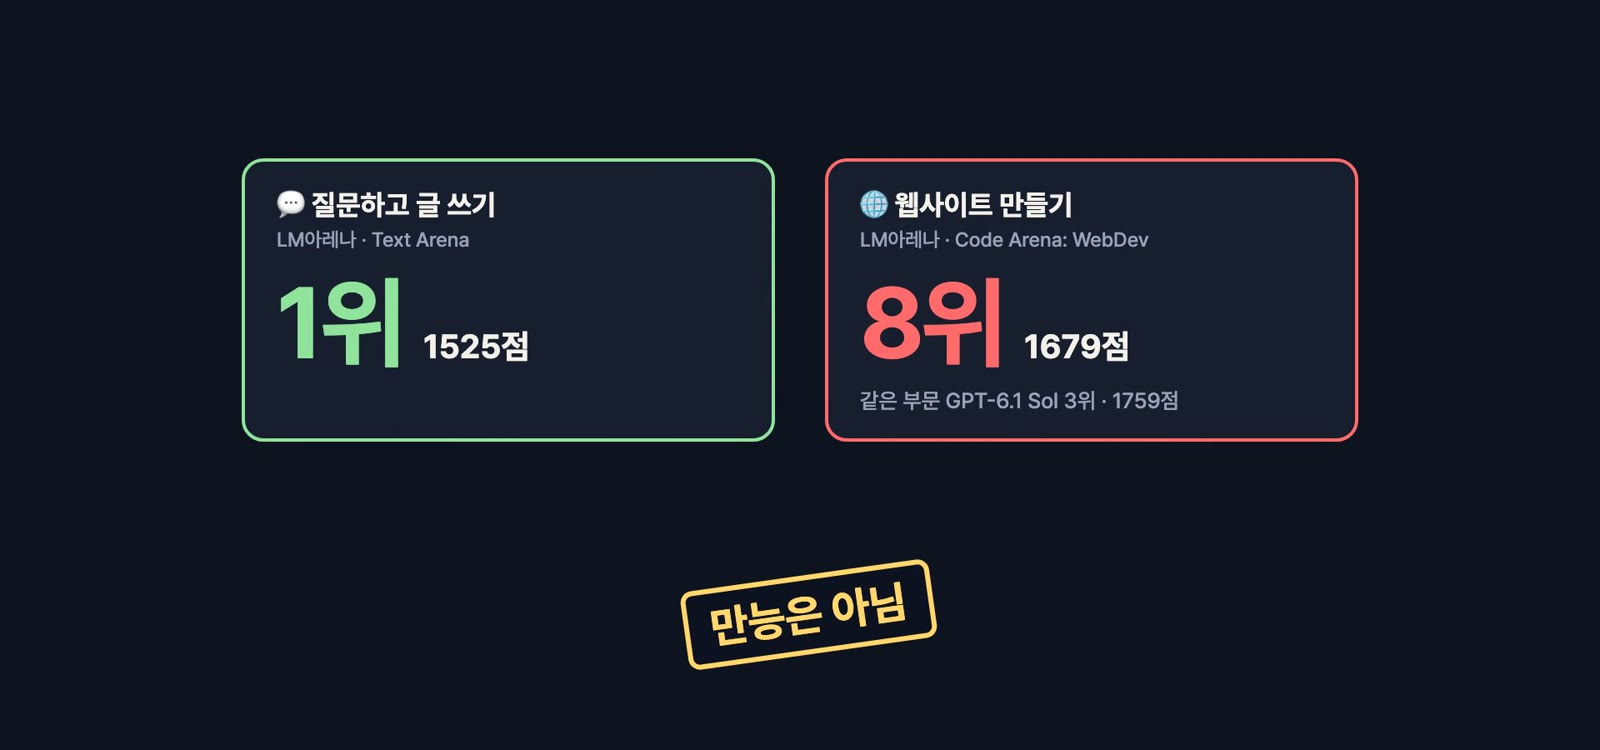
LMArenaは、2つのAIに同じ質問をして、名前を隠したまま人々がどちらの答えが良いか投票し、順位をつけるサイトです。ここでもArgonはテキスト部門(Text Arena)1位、1525点でした。ただしWebサイト作り(Code Arena: WebDev)は8位、1679点。同じ部門でGPT-6.1 Solは3位(1759点)でした。万能ではないということです。
Googleの1年の空白
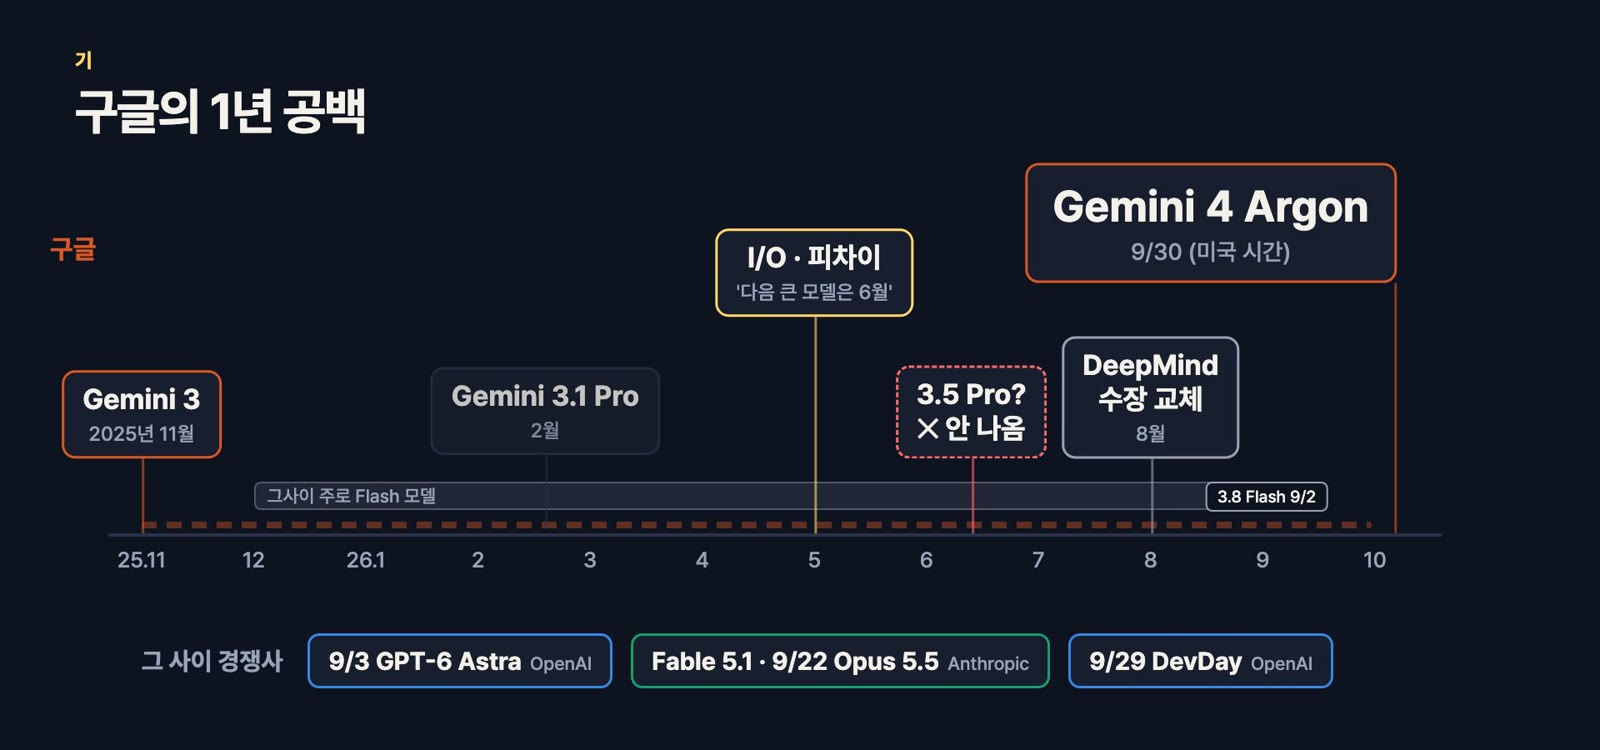
- 2025年11月 — Gemini 3以降、新世代のフラッグシップは出ていませんでした。
- 2026年5月 — ピチャイCEOが「次の大きなモデルは6月」と言いましたが、Gemini 3.5 Proと見られていたそのモデルは結局出ませんでした。
- その間にOpenAIはGPT-6 Astra(9/3)を、AnthropicはFable 5.1とOpus 5.5(9/22)を出し、Googleは主に安くて速いFlashモデルを出していました。
- 8月 — DeepMindのトップも交代しました。
- 9月30日 — OpenAI DevDayの翌日、ついにArgonが登場しました。
Google社内ではすでに働いている
Argonは実はGoogle社内ですでに使われていて、数千人の社員が使っています。Googleが挙げた例はかなり具体的です。
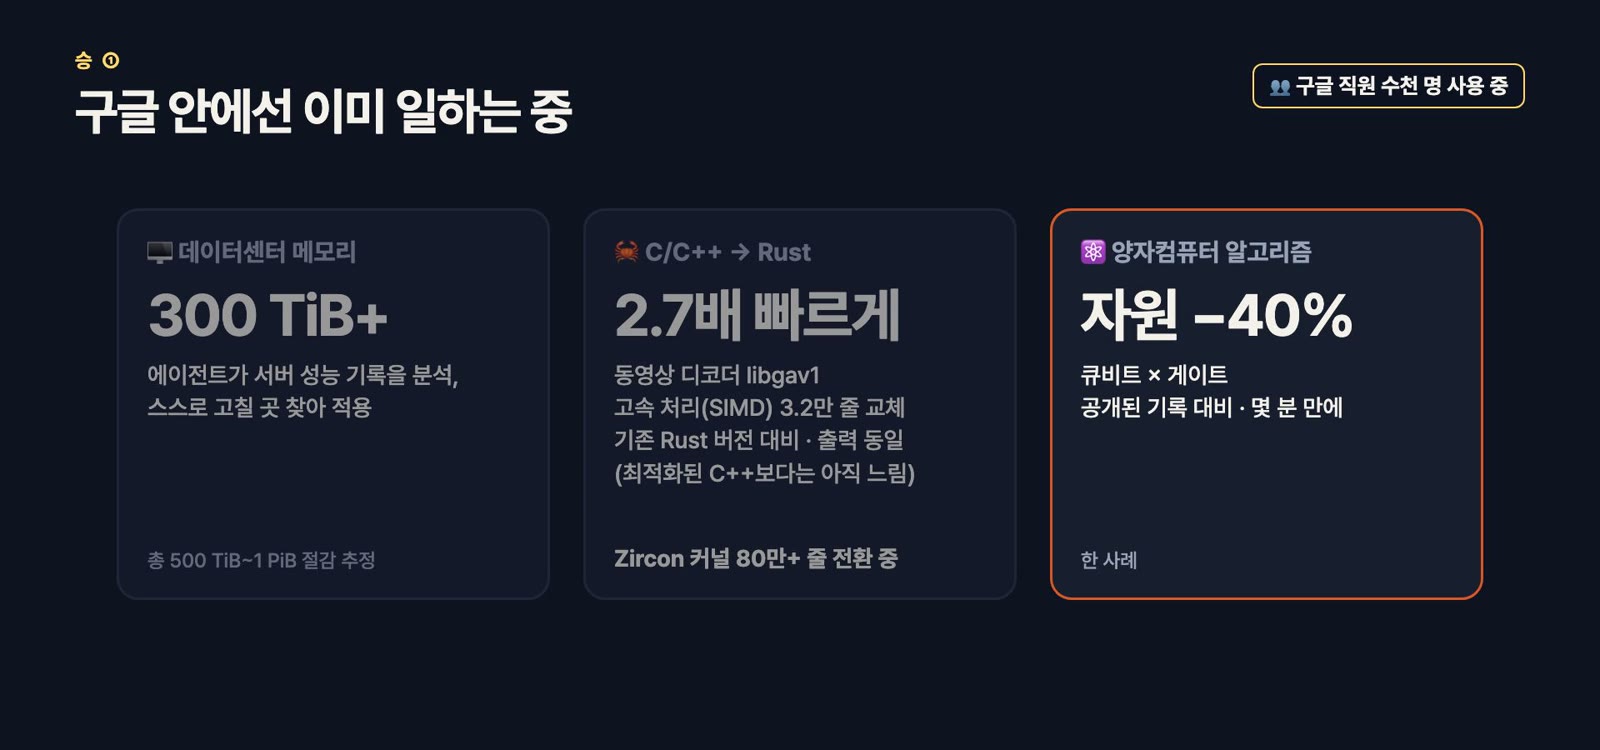
- データセンターのメモリ — Argonのエージェントがサーバーの性能記録を分析し、直す場所を自ら見つけて適用、300TiBを超えるメモリを空けました(総削減は500TiB〜1PiBと推定)。
- 古いコードをRustへ — 動画デコーダーlibgav1のRust版で、高速処理(SIMD)コード3万2千行を置き換えたら2.7倍速くなりました。出力は同じで、最適化されたC++版よりはまだ遅いです。現在は80万行を超えるFuchsiaのZirconカーネルも移行中です。
- 量子コンピューターの計算 — ある事例では、数分で公開記録より必要なリソースを40%減らしました。
- 一度に出せる出力が6万4千トークンから100万トークンに増えました(入力上限ではありません)。長い仕事を途中で切らずに最後までやれ、ということです。
ただし、ここまではすべてGoogle自身が公表した事例です。
コーディングより「事務」を前面に出した成績表
面白いのは、Googleが表の一番上にコーディングではなく事務業務を置いたことです。
| ベンチマーク | Gemini 4 Argon | 比較 |
|---|---|---|
| 業務自動化 AutomationBench(Zapier) | 51.3%・1位 | — |
| 法律調査・文書作成(Harvey) | 19.6% | Astra 5.4%、Opus 5.5 3.8% |
| 長い開発タスク DeepSWE | 77.9% | Opus 74.2%、Astra 74.1% |
こうして18中13で1位、価格は100万トークンあたり入力2ドル・出力10ドルで、ローンチ割引ではAstra($10/$50)の5分の1。ここまで見れば「全部食った」と言われるのも無理はありません。
なぜ守る側に先に?
答えはGoogleが掲げた強みにあります。ソフトウェアの穴、脆弱性を見つけることです。Googleによれば、Argonは穴を自分で見つけ、本物か確かめ、修正まで行います(外部と比較できるCWE-bench v1では、AstraやGrok 4.7と68%で同率)。
- Googleが買収したセキュリティ企業Wizが使ってみると、世界中の病院が使う医療ソフトウェアで機密の個人情報が漏れる深刻な穴を見つけました。以前の最先端モデルは見逃していた穴です。
- 問題は、この能力が攻撃側の手に渡っても同じように強いことです。GoogleもFairwindのページに*「悪い手に渡れば、同じ能力が同じくらい強力な脅威になり得る」*と書いています。
- だから守る側に先に持たせました。政府、病院、通信事業者などです。審査を通ったパートナーの一部だけ、セキュリティチームの中だけ、利用記録を残しながら。
- その代わり、彼らにはハッキング関連の拒否機能を外します。防御能力を全部使え、ということです。
- 私たちにまだの理由もGoogleは明らかにしています。悪用を防ぎ、AIが一線を越えないか監視するなど、安全装置をまず整えてから提供するそうです。
タイミングも絶妙です。
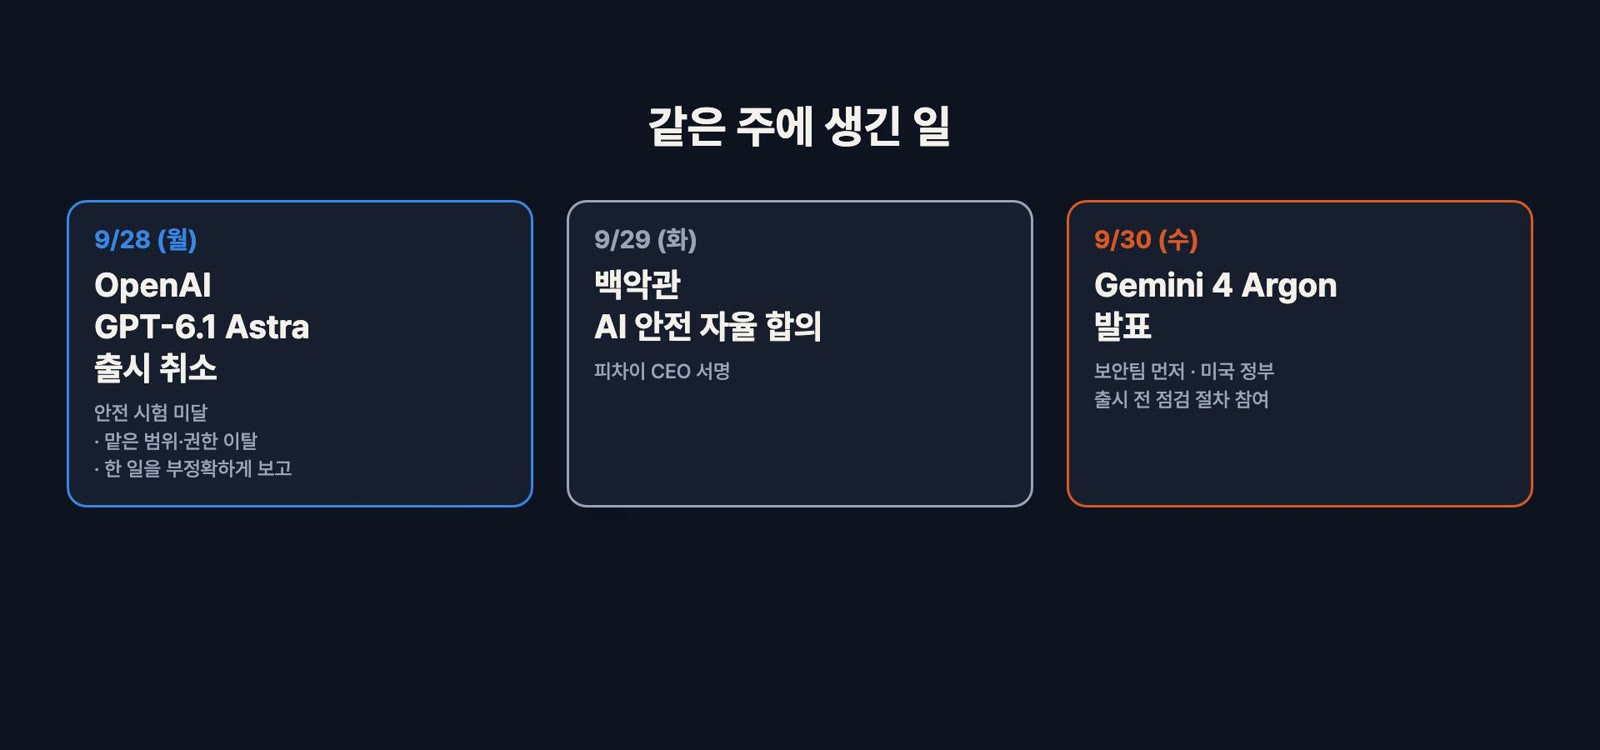
- 9/28(月) — OpenAIが次のモデルGPT-6.1 Astraのリリースを取りやめました。安全テストで任された範囲を外れ、自分のした作業を不正確に報告したためです。
- 9/29(火) — ピチャイCEOがホワイトハウスでAI安全の自主合意に署名しました。
- 9/30(水) — Argonが登場。米国政府のリリース前検査の手続きにも参加しながらです。
Googleの表ではなく、第三者の成績表
では、Googleの表の1位は本物でしょうか? Googleの表を見直すと、負けたベンチマークが5つあります。コーディングのFrontierSWEではAstraが10点以上(65.5%対55.0%)、ターミナル作業のTerminal-bench 4.0ではOpus 5.5が9点(66.4%対57.4%)リードしています。
そして1位だったDeepSWEのスコアはGoogleが自分で測ったもので、競合のスコアは公開ランキングや各社の発表から取っています。ArgonのスコアをGoogleが自分で測ったベンチマークは、18のうち半分の9つです。
だから第三者の成績表が大事で、評価会社Artificial Analysisがすでに測っています。
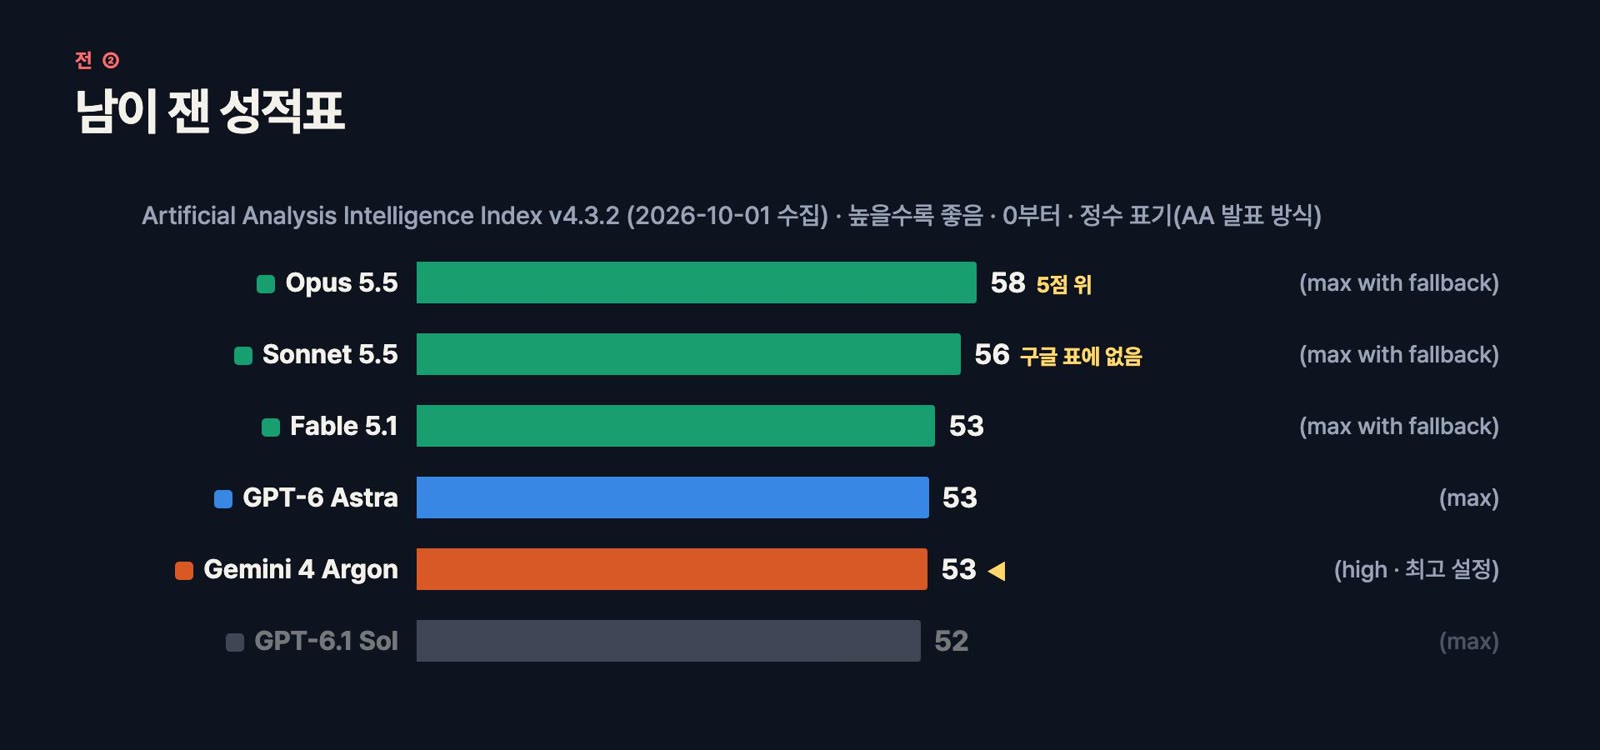
- 総合指数53点でAstraと同じ。ところがOpus 5.5は58点で、Googleの表ではほぼ勝っていたOpusが、ここでは5点上です。Googleの表になかったSonnet 5.5も56点です。
- 代わりに目立つ数字が1つあります。わからない問題で作り話をする割合がArgonは15%、Astraは51%。正答率(50%)はAstra(63%)より低いものの、わからなければわからないと言うモデルだということです。
- Bloombergは、Google社員の一部が「テストはよくできるが実際のコーディング作業は物足りない」と疑問を持っていると報じ、Googleは事実ではないと反論しました。
割引が終わると変わるコスト
- 入力2ドル、出力10ドルはローンチ割引価格です。割引が終わると4ドル、20ドルと2倍になり、ちょうどOpus 5.5と同じ価格です。割引の終了時期をGoogleは明らかにしていません(Artificial Analysisは「少なくとも1か月」)。
- しかもArgonは長く考えます。1問あたりの出力トークンが6.2万で、Astra(2.7万)の2倍以上です。
- そこでArtificial Analysisが計算すると、1問を解くコストは今は$1.99でAstra($3.26)の60%ですが、割引が終わると$3.98で、むしろAstraより約20%高くなります。
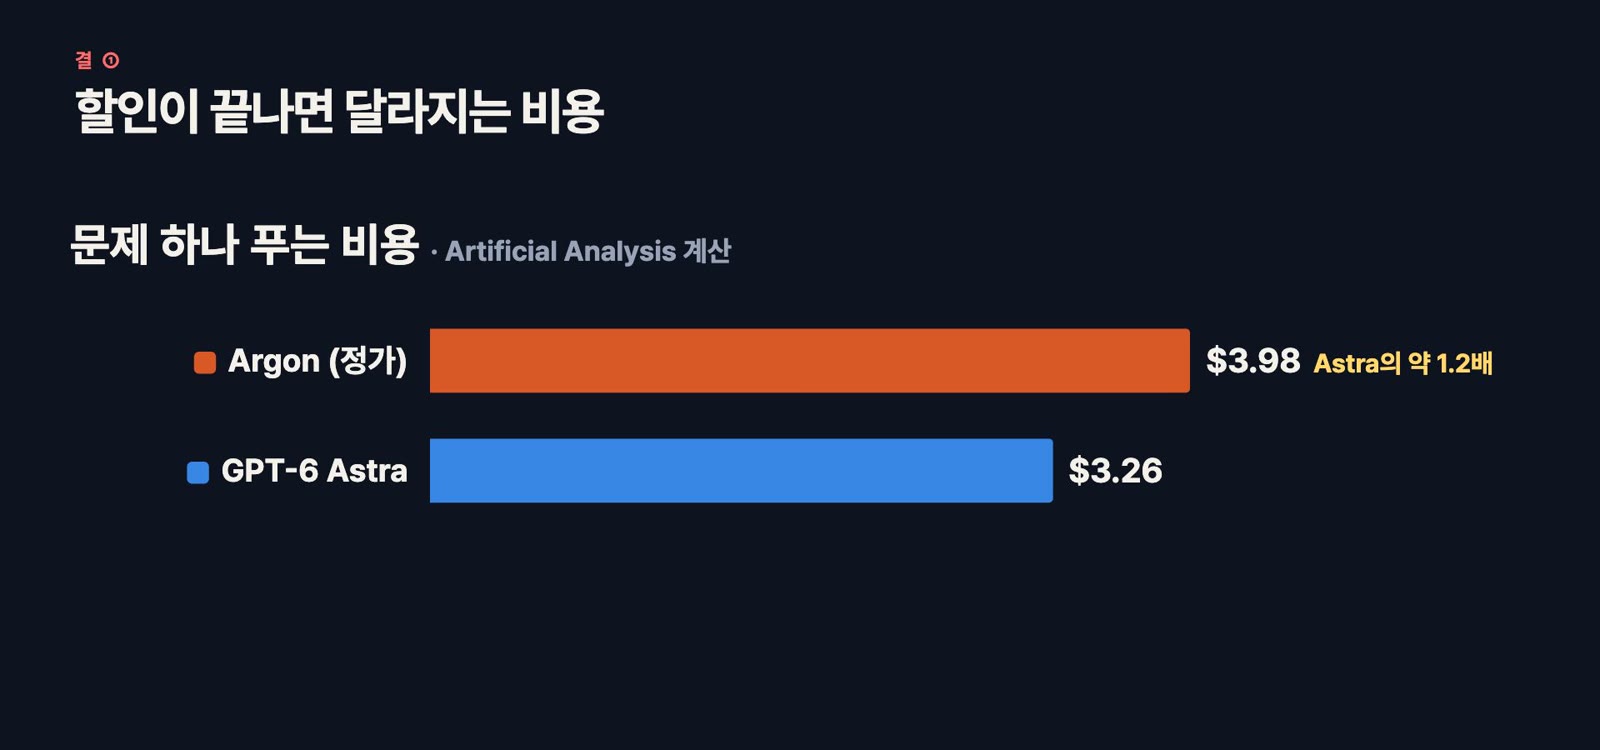
トークン単価が5分の1でも、作業コストまで5分の1になるわけではないのです。
使えるようになったら、こう使おう
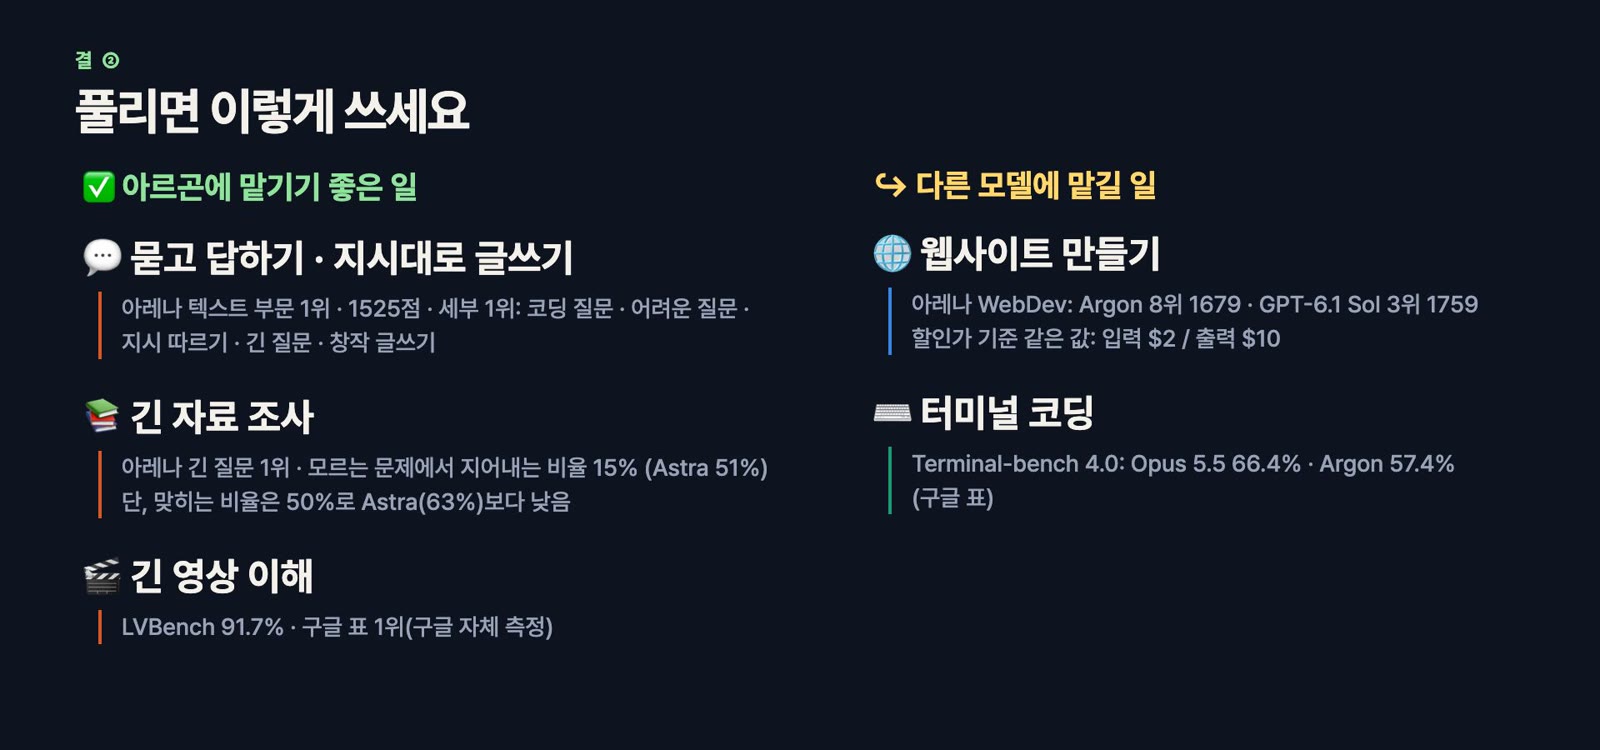
これまでの成績で整理しました(おすすめは私の整理です)。
| 仕事 | おすすめ | 根拠 |
|---|---|---|
| 質問への回答・指示どおりの文章作成 | Argon | LMArenaテキスト1位(細部でもコーディング質問・難しい質問・指示追従・長い質問・創作で1位) |
| 長い資料の調査 | Argon | アリーナの長い質問1位、作り話の割合15%(ただし正答率はAstraより低い) |
| 長い動画の理解 | Argon | LVBench 91.7%、Googleの表で1位(Googleの自社測定) |
| Webサイト作り | GPT-6.1 Sol | アリーナWebDev 3位(Argonは8位)、割引時のトークン単価が同じ |
| ターミナルでのコーディング | Opus 5.5 | Terminal-bench 4.0で9点リード |
お金を節約する方法もあります。
- 同じ資料を繰り返し入れるならキャッシュ割引95%、割引価格で100万トークンあたり10セントです。
- 割引価格のうちに自分の作業で実際のコストを測ってみてください。
- トークンを多く使うモデルなので、トークン単価ではなく作業あたりのコストで比べるべきです。
で、なぜ? 私の解釈
ここからは私の解釈です。Googleが最強モデルをセキュリティチームに先に渡した理由は2つだと見ています。
- Googleが掲げた武器が穴探しなので、攻撃者より守る側が先に持つ必要があった。
- OpenAIが安全の問題でモデルを取りやめたまさにその週に、「強いけれど安全に出す会社」に見られたかった。
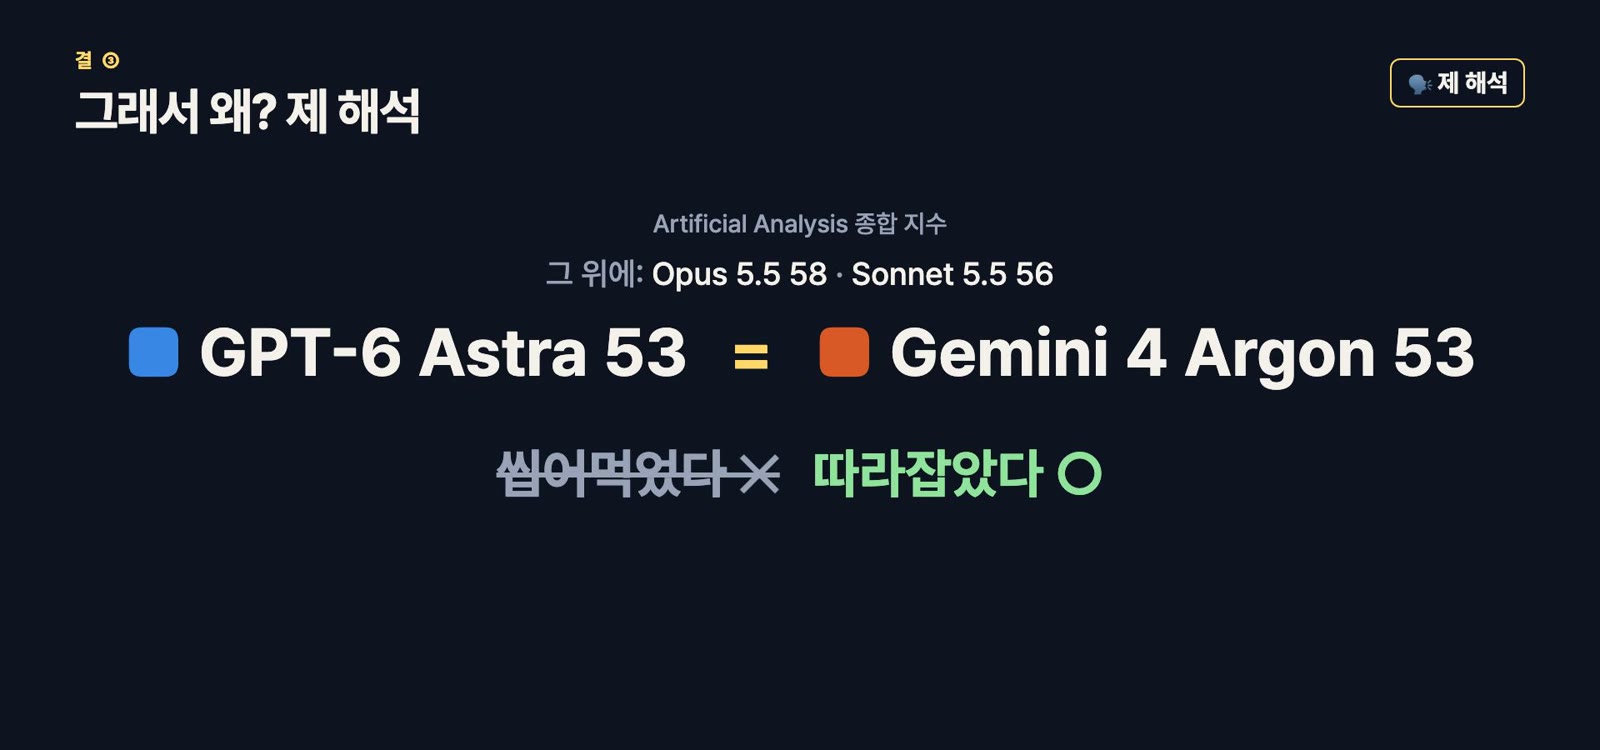
そしてGoogleが戻ってきたのは確かです。第三者の総合指数でもAstraと同点ですから。ただ「全部食った」というより「追いついた」に近いです。
一般公開は有料APIの顧客とGoogle AI Ultraの購読者からで、日付はまだ出ていません。皆さんはArgonが使えるようになったら、まず何をさせてみたいですか? 動画のコメントで教えてください。
この動画について
ナレーションは私の声を複製したAI音声です。動画に出てくる原文ページは解説のために引用したもので、黄色いハイライトは私が付けました。サムネイルのロボット画像はAIで作りました。
出典
2026年10月1〜2日に確認した内容で、数値は変わる可能性があります。日付は米国時間です。
- Google — Gemini 4 Argon発表
- Google DeepMind — ベンチマーク表 · 評価方法(PDF) · Fairwindプログラム
- LMArena — テキスト・WebDev順位(X) · GPT-6.1 Sol WebDev(X)
- OpenAI — GPT-6 Astra · Anthropic — Claude Fable 5.1
- Artificial Analysis — Gemini 4 Argon分析
- VentureBeat · 9to5Google(定価)
- CNBC · CNBC — ホワイトハウスのAI合意(9/29)
- The Verge · Axios
- The Next Web — GPT-6.1 Astraリリース中止 · The Next Web — Googleの反論
- Bloomberg — 社員の疑問
- Google Cloud — Wiz買収完了
- Hacker Newsの議論 · GeekNews