Ich habe meine Stimme in Googles KI gesteckt – und dann wurde es ernst: Gemini 3.8 TTS Voice Cloning im Test
21 Sekunden Aufnahme, 7 Sekunden Warten – und meine eigene Stimme
Am 23. September 2026 hat Google Gemini 3.8 TTS vorgestellt, sein neues Text-to-Speech-Modell. Diese Version kann die eigene Stimme aus einer kurzen Aufnahme klonen. Also habe ich meine Stimme hineingegeben – und es wurde gleich an mehreren Stellen ernst.
📌 Das Video ist auf Koreanisch – genau deshalb: Die öffentlichen TTS-Rankings bewerten Koreanisch nicht, also habe ich es selbst getestet. Wer den Blindtest „Welche ist echt?“ selbst machen möchte, sollte zuerst das Video ansehen; „Überraschung ③“ unten enthält einen Spoiler.
🇪🇺 Hinweis für Leser in Deutschland und der EU: Im Europäischen Wirtschaftsraum ist das Klonen von Stimmen in AI Studio laut Google derzeit nicht verfügbar. Dafür gilt die Klausel, nach der Inhalte aus der kostenlosen Stufe zur Produktverbesserung genutzt werden, für den EWR nicht (Details unten).
Was ist Gemini 3.8 TTS?
Es gibt zwei Modelle:
- Gemini 3.8 Flash TTS – das ausdrucksstarke Modell für Figuren, Hörbücher und Sprechertexte
- Gemini 3.8 Flash-Lite TTS – das günstige, schnelle Modell für Massen-Synchronisation und Sprachagenten
Flash unterstützt 130 Sprachen, Flash-Lite 101 (Koreanisch eingeschlossen), dazu kommen über 2.000 fertige Stimmen. Die zwei wichtigsten Neuerungen: Voice Design – man beschreibt eine Stimme in Worten und sie wird erzeugt – und Voice Replication, das Klonen einer Stimme aus einer kurzen Aufnahme.
Überraschung ① Der Preis ist kaum zu glauben
Laut Preisliste kostet eine Stunde Audio mit Flash etwa 0,81 US-Dollar, mit Flash-Lite etwa 0,54 US-Dollar.
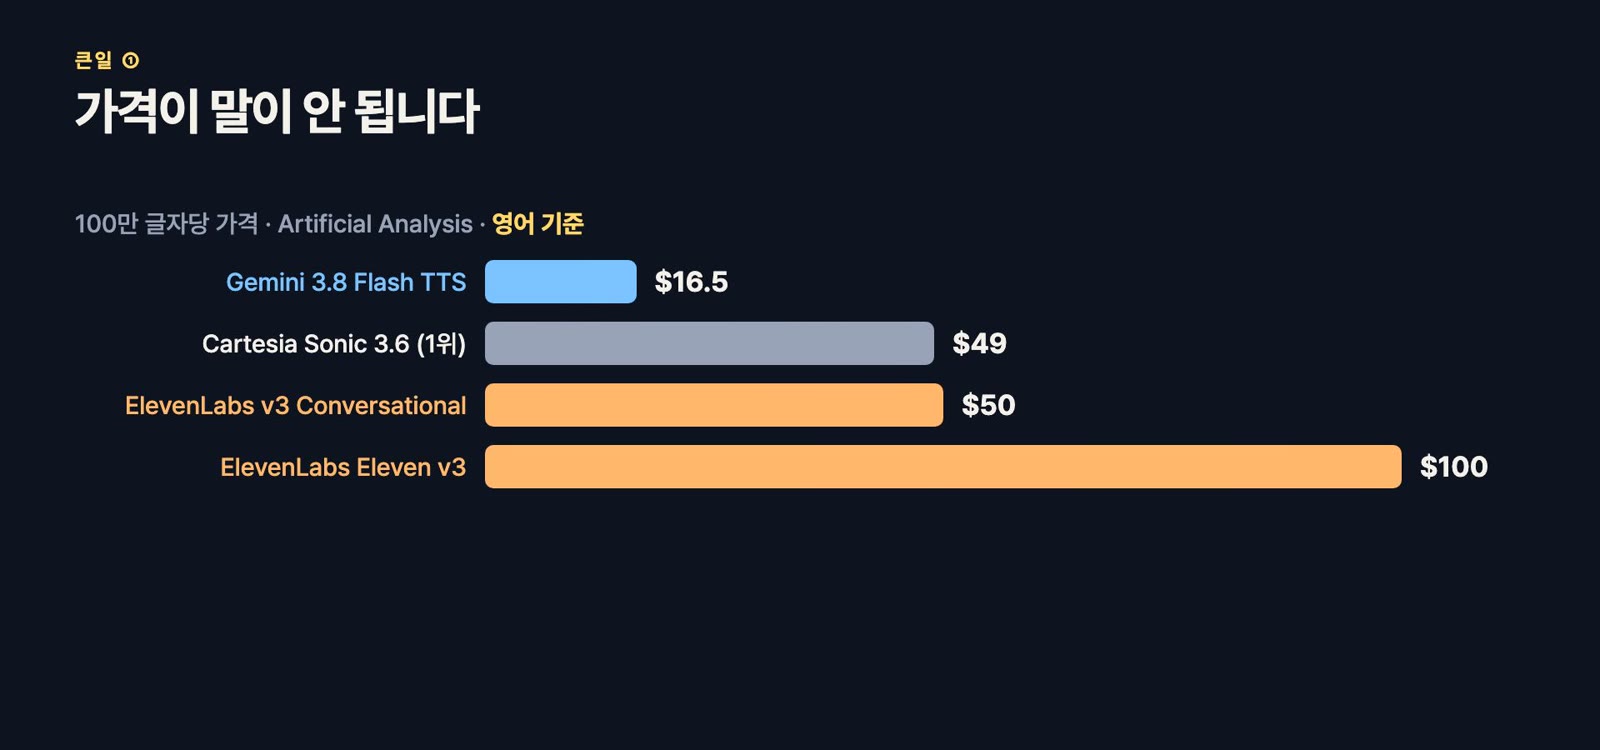
Mit den Preisen pro Million Zeichen (Englisch) von Artificial Analysis wird der Abstand deutlicher:
| Modell | Pro 1 Mio. Zeichen |
|---|---|
| Gemini 3.8 Flash TTS | 16,5 $ |
| Cartesia Sonic 3.6 (Platz 1 bei Standardstimmen) | 49 $ |
| ElevenLabs v3 Conversational | 50 $ |
| ElevenLabs Eleven v3 | 100 $ |
Das ist ein Drittel des Spitzenmodells und ein Drittel bis ein Sechstel der neuesten ElevenLabs-Modelle. Es gibt sogar eine kostenlose Stufe – und genau dieses „kostenlos“ wird später zum eigentlichen Problem.
Überraschung ② Das teure Abo steht auf dem Prüfstand
Günstig ist nicht alles. In der Arena von Artificial Analysis (Englisch, Standardstimmen), in der Menschen in Blindvergleichen abstimmen, liegt Gemini 3.8 Flash TTS auf Platz 2. Der Abstand zu Platz 1, Cartesia Sonic 3.6 (1.279 Punkte), beträgt 14 Punkte – weniger als die Fehlermarge von ±17, also praktisch gleichauf. Die beiden neuesten ElevenLabs-Modelle (1.196 und 1.169) liegen dahinter.
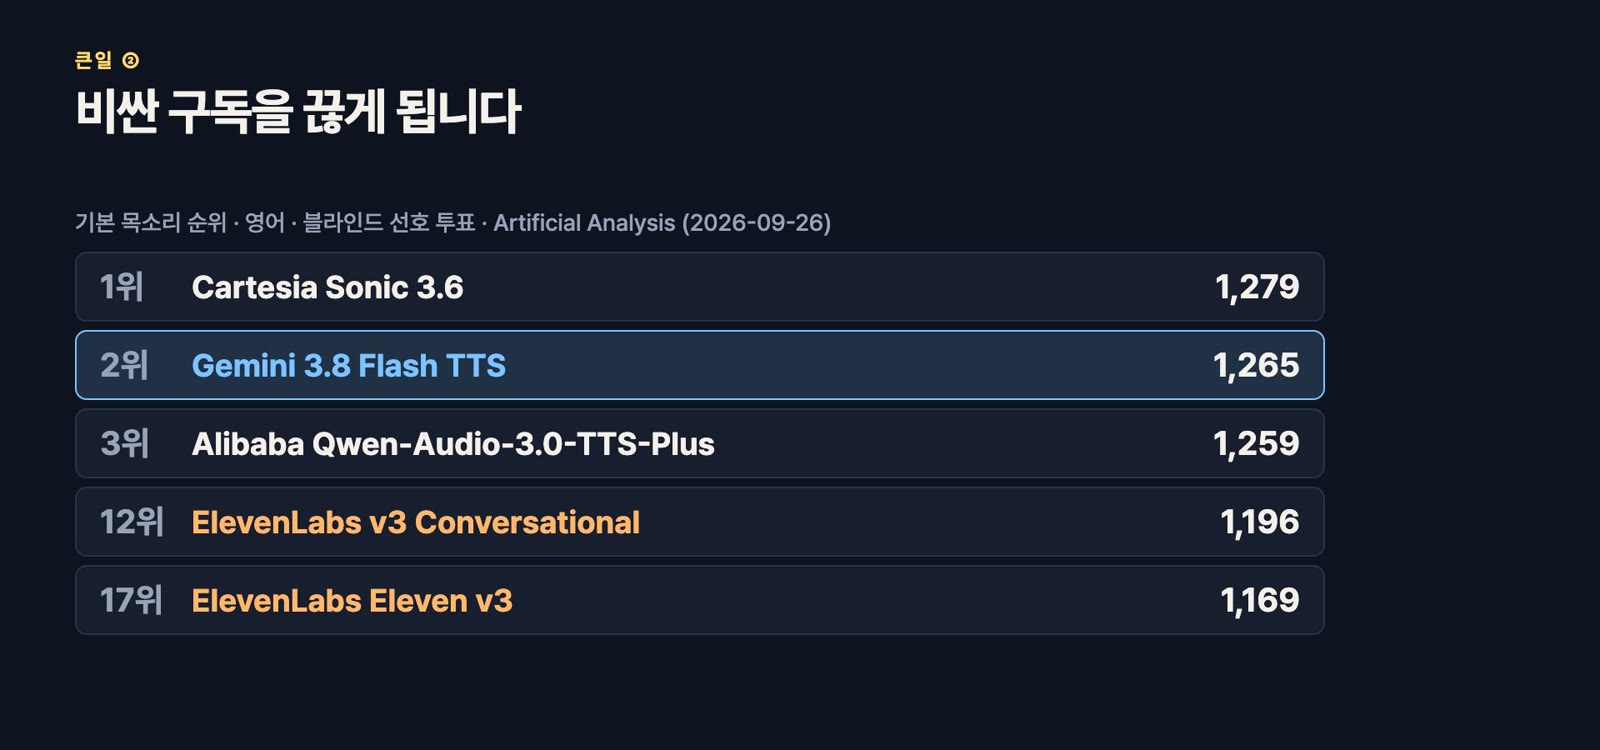
Beim Klonen sieht es anders aus. Im Ranking, das dieselben acht geklonten Stimmen vergleicht (Controlled Voice, Englisch), fällt Gemini 3.8 Flash TTS auf Platz 12, während ElevenLabs Eleven v3 mit Platz 6 vorne liegt. Wer nur Standardstimmen braucht, sollte sein teures Abo überdenken – die Klonqualität muss man aber gesondert bewerten.
Und wie sieht es auf Koreanisch aus, mit meiner eigenen Stimme? Ich habe es ausprobiert.
Welche ist echt? – ein Blindtest
Ich habe denselben Satz mit drei Stimmen vorbereitet:
- meine echte Aufnahme
- meine mit Gemini geklonte Stimme
- meine mit ElevenLabs v3 geklonte Stimme
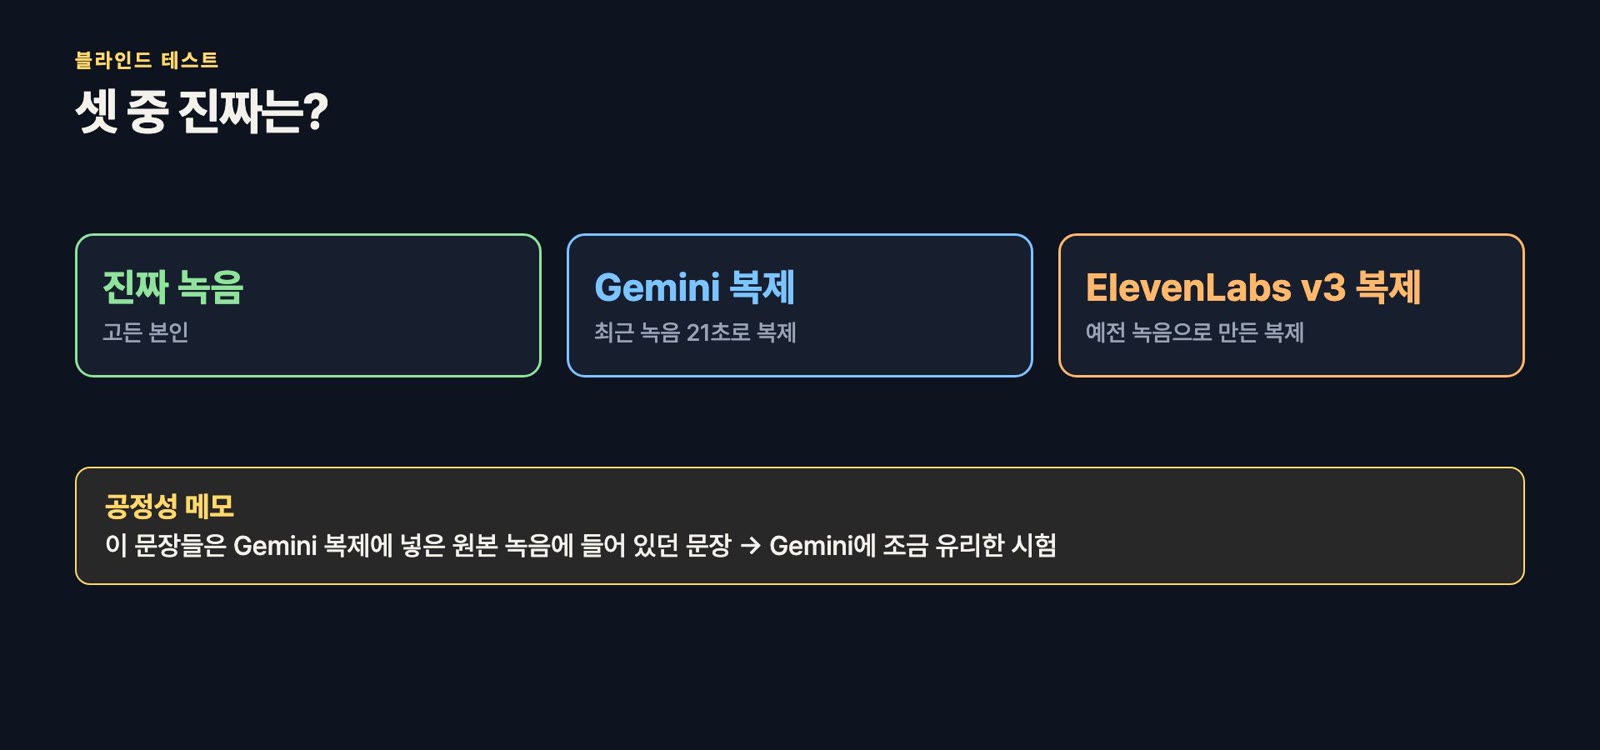
Im Video sind sie als A, B und C gemischt, in zwei Runden (ab 1:47). Offenlegung: Die Testsätze stammen aus der Aufnahme, mit der ich den Gemini-Klon erstellt habe – der Test begünstigt Gemini also leicht. Schreibt in die Videokommentare, wie viele ihr richtig hattet.
Überraschung ③ Meine Stimme wird nicht mehr gebraucht
⚠️ Spoiler: Das ist die Wendung des Videos.
Abgesehen von den Stellen, die ich ausdrücklich als echte Aufnahmen kennzeichne, ist die gesamte Erzählstimme mein mit Gemini geklonter Klang. Ich habe nur das Skript eingetippt.
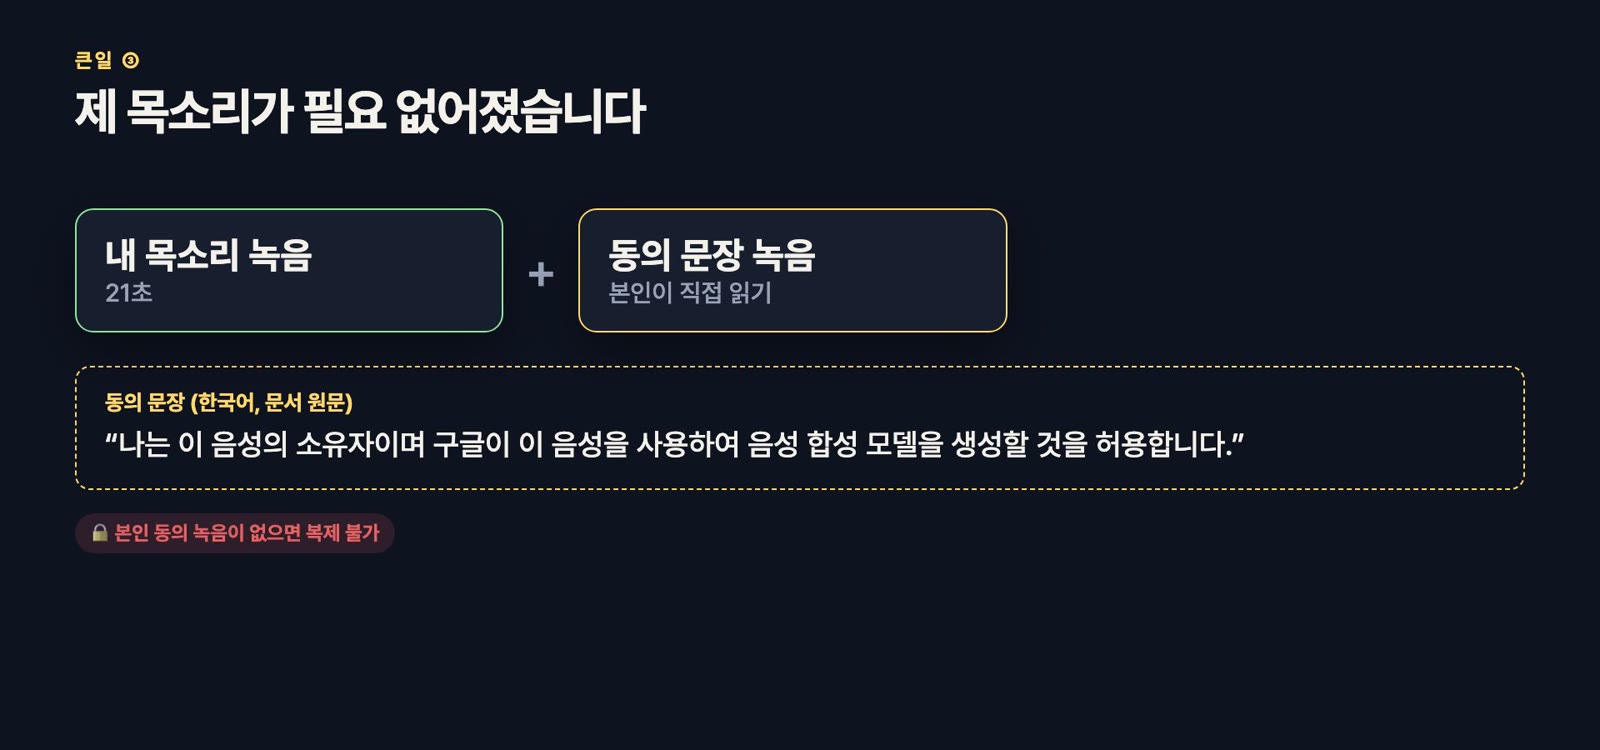
Für den Klon brauchte es zwei Dinge:
- Eine Aufnahme der eigenen Stimme – 10 bis 30 Sekunden. Ich habe 21 Sekunden verwendet.
- Eine Einwilligungsaufnahme – man liest selbst eine Erklärung vor. Die Dokumentation stellt sie in 30 Sprachen bereit; sinngemäß: Man ist Inhaber dieser Stimme und erlaubt Google, damit ein Sprachsynthesemodell zu erstellen.
Ohne eine Einwilligung, die dieselbe Person gelesen hat, ist das Klonen gesperrt. Ich habe beide Dateien hochgeladen, und gut 7 Sekunden später war meine Stimme fertig.
Spannend ist das Alter der Stimme. Mein älterer ElevenLabs-Klon entstand aus Aufnahmen von vor einigen Jahren und klingt für mich etwas jünger; der Gemini-Klon basiert auf einer aktuellen Aufnahme. Die KI kopiert also sogar, wie alt eine Stimme klingt.
Überraschung ④ Im Skript steht jetzt auch das Schauspiel
Man wählt keine Stimme mehr aus – man beschreibt sie. „Eine warme, rauchige Erzählerin in ihren Sechzigern“ oder „ein leicht erregbarer Sportkommentator in seinen Zwanzigern“ – ein, zwei Sätze genügen.
Regieanweisungen lassen sich als Tags wie <short pause>, <sigh> oder <laugh> direkt ins Skript schreiben, und ein Stil wie „flüsternd“ lässt die Stimme flüstern. Dialoge mit zwei Personen entstehen in einer einzigen Anfrage (mit Standardstimmen). Das Casting von Sprechern wird zu etwas, das man schreibt.
So probiert man es aus – Google AI Studio
Ohne Code geht es direkt auf der Sprachgenerierungsseite von Google AI Studio.
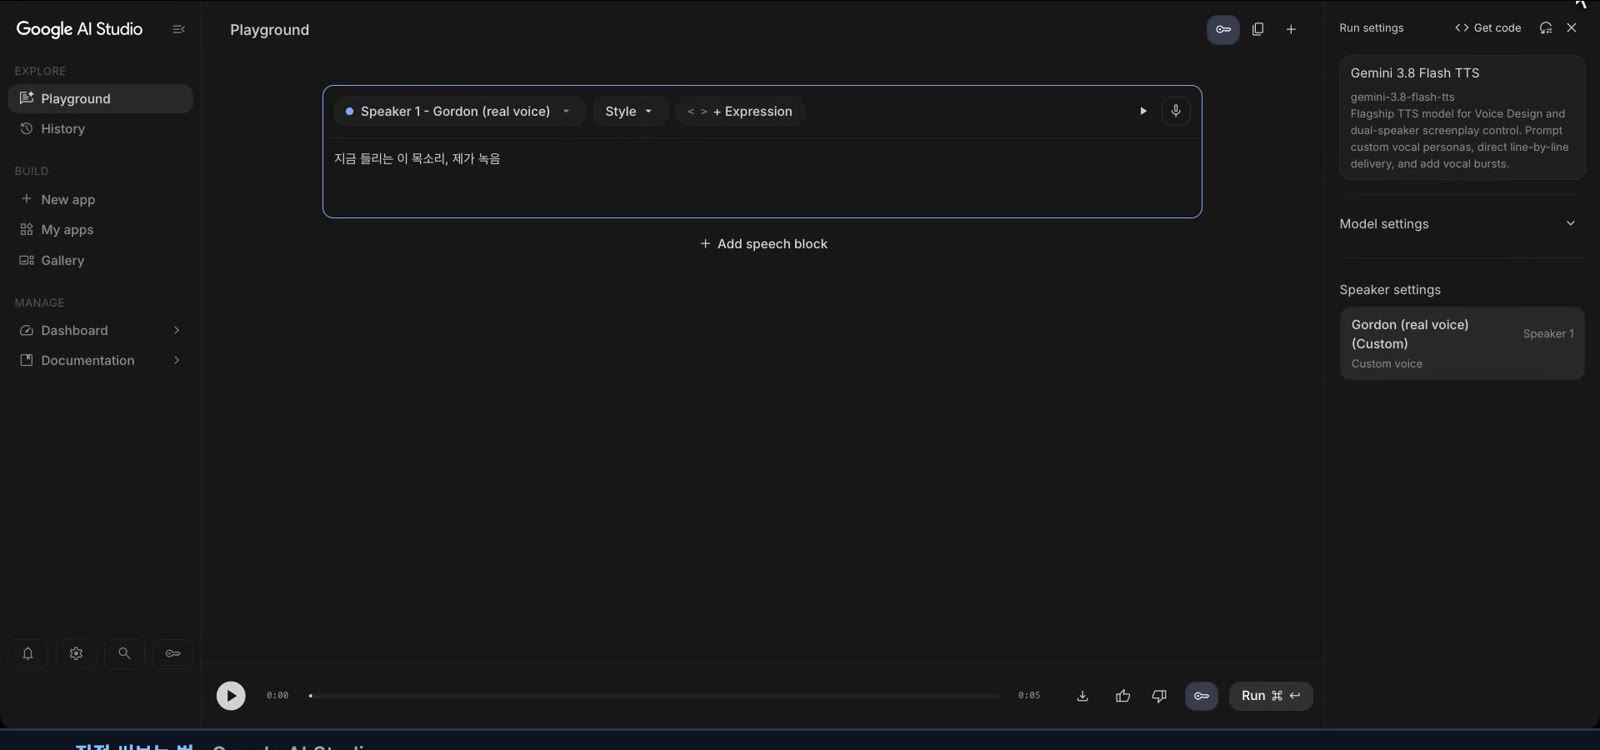
- In AI Studio „Generate speech“ öffnen und Gemini 3.8 Flash TTS wählen.
- Text eingeben und Run drücken – der Text wird sofort vorgelesen.
- Über die Stimmen-Schaltfläche eine der über 2.000 Stimmen wählen oder per Klonen bzw. Design eine neue erstellen. Beides erfordert einen API-Schlüssel mit hinterlegter Abrechnung. Die beiden Aufnahmen fürs Klonen lassen sich direkt dort aufnehmen.
- Die Sprechweise ins Feld Style schreiben (z. B. „fassungslos und gekränkt“). Mit Enter bestätigen – schließt man das Feld einfach, wird der Stil nicht angewendet.
- Schauspiel-Tags muss man nicht auswendig kennen: In der Expression-Liste anklicken, und der Tag landet an der Cursorposition.
- Für Voice Design eine Beschreibung eingeben und Generate drücken; es gibt drei Kandidaten zum Anhören und Auswählen.
💡 Vorsicht bei „Get code“: Man kann Python-Code exportieren, aber der Style-Text fehlt, und eine geklonte Stimme wird über ihren Anzeigenamen statt ihre ID referenziert. Unverändert ausgeführt schlägt der Aufruf mit HTTP 400 fehl – Stimmen-ID und Stil muss man selbst nachtragen.
Das eigentliche Problem ① Die kostenlose Nutzung
Alles bisher war eigentlich Angeberei. Jetzt die drei echten Probleme.
Ich sagte, meine Stimme werde nicht mehr gebraucht. In der kostenlosen Stufe könnte Google sie aber brauchen.
- Laut Gemini-API-Preisliste wird die kostenlose Nutzung zur Verbesserung von Googles Produkten verwendet (die kostenpflichtige nicht).
- Laut Nutzungsbedingungen können Inhalte und Ergebnisse aus dem unbezahlten Dienst zur Verbesserung von Googles Produkten und KI genutzt und von menschlichen Prüfern gelesen werden. Vor der Prüfung werden sie vom Konto getrennt – aber eine Stimme verrät für sich allein, wer spricht. Die Bedingungen raten zudem, keine personenbezogenen Daten zu senden.
- Das Klonen einer Stimme funktioniert aber nur, indem man seine Stimme sendet. AI Studio öffnet das Klonen nur für kostenpflichtige Schlüssel; ob auch kostenlose API-Schlüssel gesperrt sind, steht nicht in der Dokumentation.
- Die Nutzungsdaten zeigen, dass bei jeder Anfrage mit geklonter Stimme die Originalaufnahme als Eingabe mitgezählt wird.
Ich habe das erst gelesen, nachdem ich meine Stimme geklont hatte. Zum Glück war mein Schlüssel kostenpflichtig, mit hinterlegter Abrechnung. Kostenpflichtige Nutzung mit Abrechnungskonto wird nicht zur Produktverbesserung verwendet, Protokolle zur Missbrauchsüberwachung bleiben aber eine Zeit lang gespeichert. Für Nutzer im Europäischen Wirtschaftsraum, im Vereinigten Königreich und in der Schweiz gilt diese Klausel auch in der kostenlosen Stufe nicht – für Nutzer etwa in Südkorea schon.
Das eigentliche Problem ② Vielleicht weniger günstig als gedacht
- Außerhalb des Englischen schrumpft der Abstand. Der Preisvergleich oben bezog sich auf englische Zeichen. Gemini rechnet nach Audiolänge ab, und Koreanisch wird mit weniger Zeichen pro Sekunde gesprochen als Englisch (in diesem Video etwa 8,3 pro Sekunde, geschätzt etwa 13,6 für Englisch). Gegenüber Diensten, die pro Zeichen abrechnen, wird der Unterschied im Koreanischen kleiner.
- Der aktuelle Preis ist befristet. Ab dem 1. Januar 2027 verdoppelt sich der Preis von Flash und Flash-Lite – aus 0,81 US-Dollar pro Stunde werden 1,62 US-Dollar.
Das eigentliche Problem ③ Was es noch nicht kann
- Keine Werte für Koreanisch. Keines der großen öffentlichen Rankings, die ich geprüft habe, bewertet Koreanisch – deshalb der Test im Video.
- Manche Rezensionen sagen, die Standardstimmen klängen alle ähnlich.
- Dialoge sind auf zwei Sprecher pro Anfrage beschränkt, und nur mit Standardstimmen. Geklonte Stimmen muss man einzeln erzeugen und zusammensetzen.
- Keine veröffentlichten Latenzwerte – für Echtzeit-Support also genau prüfen.
- In manchen Regionen (laut AI Studio: Vereinigtes Königreich, EWR, Schweiz, Indien, Texas und Illinois) ist das Klonen komplett gesperrt.
Wer Missbrauch befürchtet: Google verlangt die Einwilligungsaufnahme und versieht jede erzeugte Sprachausgabe mit einem SynthID-Wasserzeichen – das man allerdings nicht hören kann.
Also: Sollte man es nutzen?
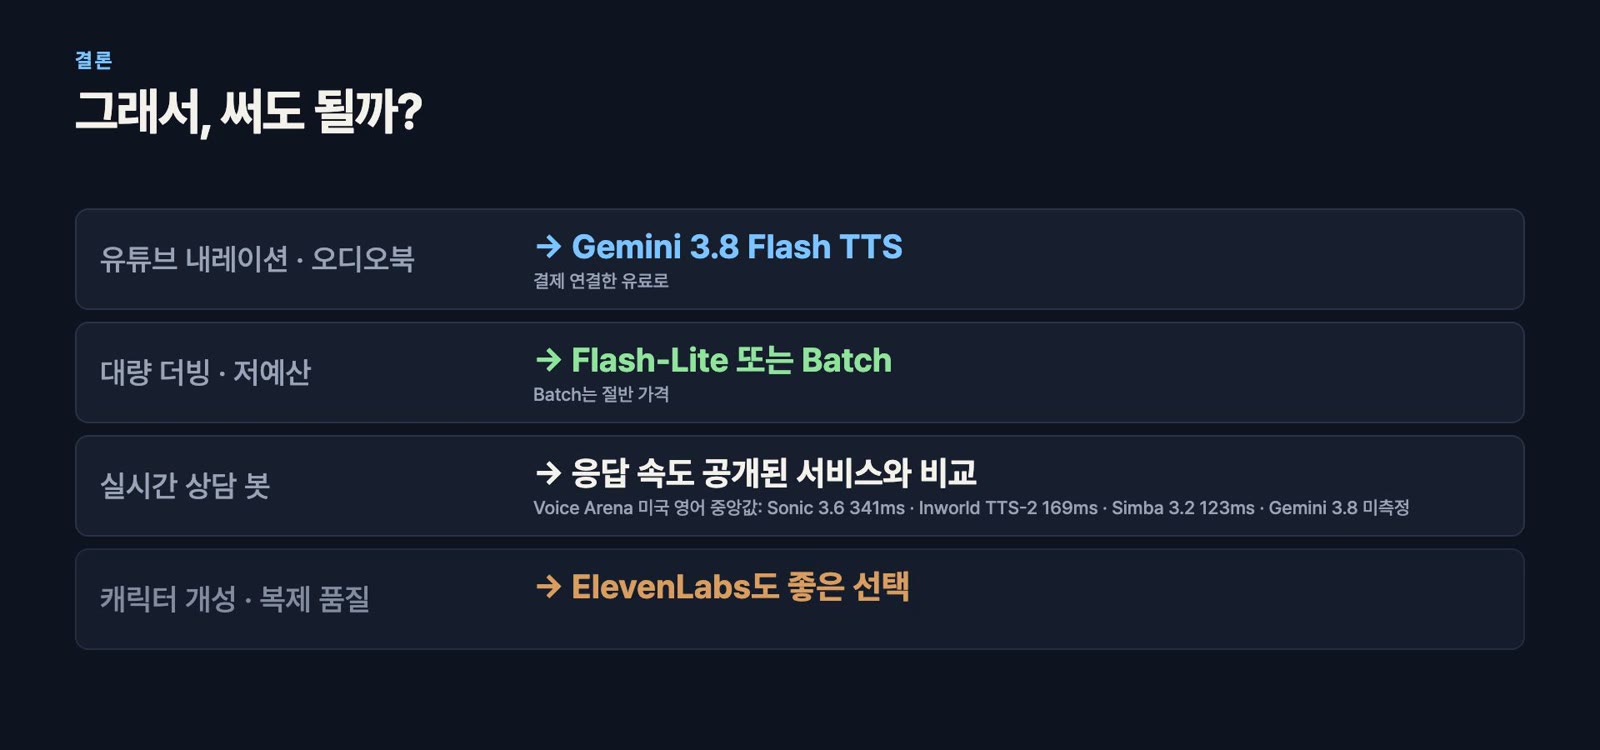
| Einsatzzweck | Empfehlung |
|---|---|
| YouTube-Sprechertexte, Hörbücher | Gemini 3.8 Flash TTS – gut genug, aber kostenpflichtig mit Abrechnung |
| Massen-Synchronisation, kleines Budget | Flash-Lite oder das halb so teure Batch |
| Echtzeit-Support-Bots | Zuerst mit Diensten vergleichen, die Latenzen veröffentlichen (Voice Arena, Median US-Englisch: Sonic 3.6 341 ms · Inworld TTS-2 169 ms · Simba 3.2 123 ms; Gemini 3.8 nicht gemessen) |
| Charakter, Klonqualität | ElevenLabs bleibt eine gute Wahl |
Drei Dinge, auf die man achten sollte: die Bedingungen der kostenlosen Stufe, den Preis ab 2027 und – bei anderen Sprachen als Englisch – selbst hinhören, bevor man sich entscheidet.
Wie dieses Video entstanden ist
Für die gesamte Erzählstimme habe ich weniger als eine Minute ins Mikrofon gesprochen – die Vorlage zum Klonen, die Einwilligungserklärung und die echten Aufnahmen für den Blindtest. Alles andere war Text.
Das Video selbst begann mit ein paar Zeilen an Claude Code, ein KI-Programmierwerkzeug: die URL von Googles Ankündigung und diese zwei Zeilen (auf Koreanisch):
gemini 3.8 tts 가 매우 좋다고 하는데, 장단점과 타사와 비교등을 해서 가장 중요한 것을 궁금한 것으로(훅) 만들어서,
영상을 제작했으면 해. 먼저 관련 정보를 조사를 해도 되고, 해줄 수 있어?
„Gemini 3.8 TTS soll sehr gut sein. Vergleiche Vor- und Nachteile mit anderen Anbietern, mach aus dem wichtigsten Punkt eine neugierig machende Frage (Hook) und produziere daraus ein Video. Du kannst zuerst recherchieren – schaffst du das?“
Im weiteren Gespräch haben wir das Langformat, den Hook „sieht aus wie ein Verlust“, das Klonen meiner Stimme und die Skriptprüfung festgelegt. Recherche, Skript, Sprachausgabe und Videoschnitt bauen alle auf diesem Verlauf auf.
Quellen
Geprüft vom 23. bis 26. September 2026; Zahlen können sich ändern.
- Google-Ankündigung – Gemini 3.8 Text-to-Speech
- Gemini 3.8 Flash TTS – Modelldokumentation
- Gemini-API-Preise
- Gemini-API-Nutzungsbedingungen (kostenlos und kostenpflichtig)
- Leitfaden zur Voice Replication
- Artificial Analysis TTS-Leaderboard (Englisch)
- Latenzvergleich (zitiert Voice Arena)
- eesel-AI-Rezension
- SynthID